几乎每一场 Java 后端面试都绕不开 GC,但很多同学对 GC 的理解停留在"分代回收"这四个字,一旦被追问"G1 和 CMS 有什么区别"就语塞。这篇文章按照面试官提问的递进顺序,把 GC 知识体系重新捋一遍。
一、如何判断对象已经死亡
JVM 主要采用可达性分析算法,从一组 GC Roots 出发进行引用链的遍历,不可达的对象即为可回收对象。相比引用计数法,可达性分析能够解决循环引用的问题,这也是面试中常见的对比考点。
- GC Roots 包括虚拟机栈中引用的对象、方法区中静态属性引用的对象、本地方法栈中 JNI 引用的对象等
- 四种引用类型:强引用、软引用、弱引用、虚引用,影响对象的回收时机
- 对象的 finalize() 方法只会被调用一次,不建议依赖它做资源释放
二、分代收集的设计思想
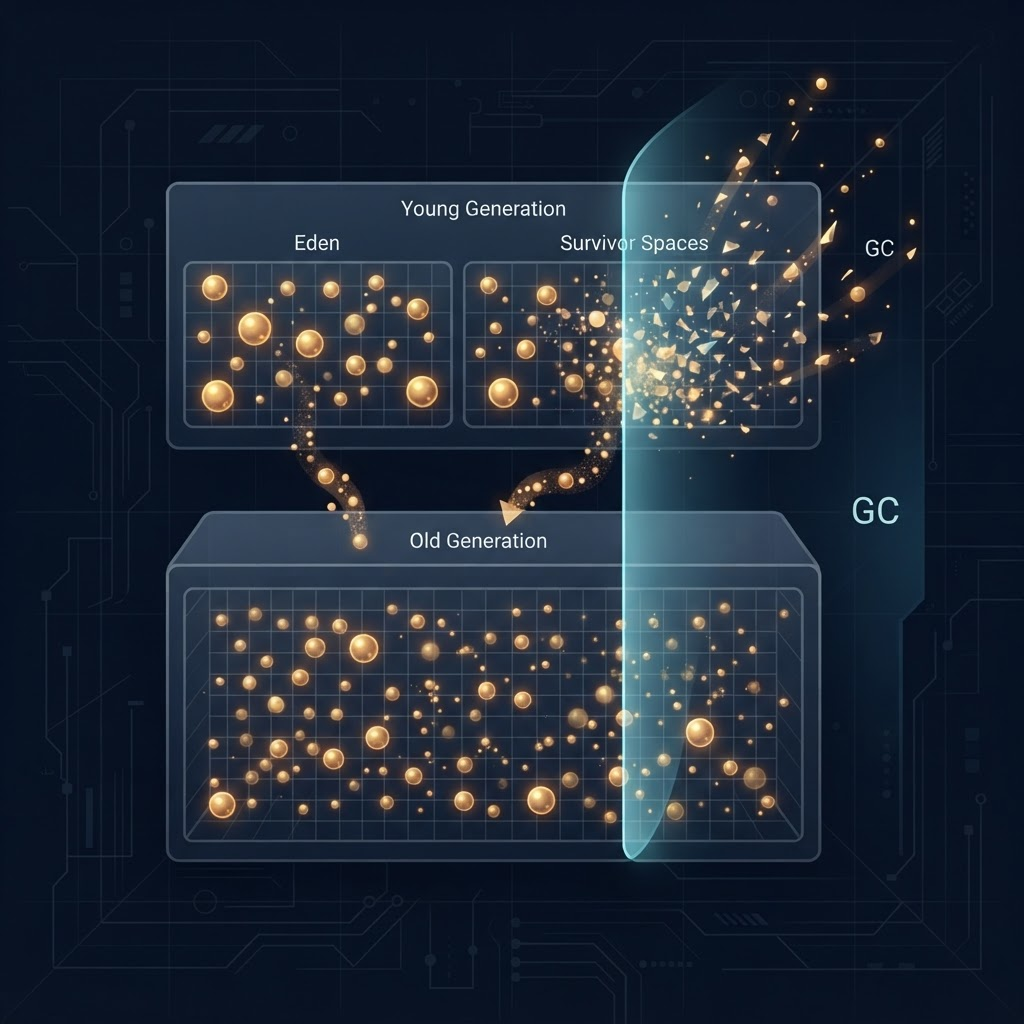
基于"大部分对象朝生夕灭"的经验假设,JVM 堆被划分为新生代与老年代。新生代又分为 Eden 区与两个 Survivor 区,对象优先在 Eden 分配,经过多次 Minor GC 存活的对象晋升至老年代。
# 常见的堆内存参数配置
-Xms4g -Xmx4g
-XX:NewRatio=2
-XX:SurvivorRatio=8
-XX:+PrintGCDetails
三、从 CMS 到 G1,再到 ZGC
CMS 采用标记-清除算法,优点是并发收集停顿时间短,缺点是会产生内存碎片。G1 将堆划分为多个大小相等的 Region,通过"停顿预测模型"控制每次 GC 的停顿时间,是目前默认的垂直扩展方案。ZGC 则进一步把停顿时间压缩到毫秒级以内,核心是染色指针与读屏障技术。
面试官真正想考察的,不是你记住了多少收集器的名字,而是你是否理解"停顿时间"与"吞吐量"之间的权衡取舍。
四、面试高频追问方向
- 你的项目线上出现过 Full GC 频繁的问题吗?如何排查和优化?
- 如何通过 GC 日志判断内存泄漏 vs 内存不足?
- 如果让你选型一个低延迟交易系统的 GC 策略,你会怎么选?
建议结合自己项目中的实际内存表现来准备答案,这类"结合场景"的回答远比背诵定义更有说服力,也是辅导中重点打磨的方向。
#JVM#垃圾回收#面试高频